kikitori Tech Blog

株式会社kikitoriは、農業流通現場のDXを実現するSaaS『nimaru』と青果店『KAJITSU』を運営する会社です。

Goのerrgroupパッケージ

はじめに

こんにちは。kikitoriの坂村です。 私が担当しているプラットフォーム事業についてはバックエンドはGoを使って開発しているのですが、先日Claude Codeと実装を進めていると初めて見るerrgroupなるパッケージに触れる機会があったのでメモがてらの共有&解説記事となります。

errgroup なにやつ?

golang.org/x/sync/errgroup 実は2016年ころに準標準パッケージとしてリリースされてたようでした。10年前からあったのにまったく触れる機会なく車輪の再発明のような実装を繰り返してきて恥ずかしい限りですが、AIで開発することによって逆に新たなインプットを得られることもあるんだなと見逃してやってください。。。

何をやってくれるかというと、たとえば複数のマイクロサービスに対してデータをかき集めてゴニョゴニョするんだけど、もし何かしらのマイクロサービスでエラーになったら他の並列処理はキャンセルして、呼び出し元に処理を戻すときなんかを想像してもらうと良いかと思います。(地道に実装すると結構めんどいやつ)

使い方サンプル

   g, gctx := errgroup.WithContext(ctx)
    for i := 0; i < 10; i++ {
        g.Go(func() error {
            path, err := DoSomething(gctx)
            if err != nil {
                return err
            }
        })
    }
    if err := g.Wait(); err != nil {
        return err
    }
  1. errgroup.WithContextで複数のgoroutineを管理するGroupを作成(1行目)
  2. それを使ってg.Goで非同期実行(3行目)
  3. g.Waitで非同期で走らせてるgoroutineの終了を待つ(10行目)

こんだけ。めっちゃ簡単。

ソースを読んでみる(v0.16.0)

type Group struct {
    cancel func(error)

    wg sync.WaitGroup

    sem chan token

    errOnce sync.Once
    err     error
}


func WithContext(ctx context.Context) (*Group, context.Context) {
    ctx, cancel := context.WithCancelCause(ctx)
    return &Group{cancel: cancel}, ctx
}

最初のWithContextの中身的にはWithCancelCauseで引数のctxをwrapしてて、管理下のgoroutineの実行を止めたいときに呼ぶためのcancel関数をGroupにプロパティに持っておく形になってます。(contextのキャンセルについてはこれはこれで結構奥深いのでまた別の機会に)

func (g *Group) Go(f func() error) {
    if g.sem != nil {
        g.sem <- token{}
    }

    g.wg.Add(1)
    go func() {
        defer g.done()

        // It is tempting to propagate panics from f()
        // up to the goroutine that calls Wait, but
        // it creates more problems than it solves:
        // - it delays panics arbitrarily,
        //   making bugs harder to detect;
        // - it turns f's panic stack into a mere value,
        //   hiding it from crash-monitoring tools;
        // - it risks deadlocks that hide the panic entirely,
        //   if f's panic leaves the program in a state
        //   that prevents the Wait call from being reached.
        // See #53757, #74275, #74304, #74306.

        if err := f(); err != nil {
            g.errOnce.Do(func() {
                g.err = err
                if g.cancel != nil {
                    g.cancel(g.err)
                }
            })
        }
    }()
}

func (g *Group) Wait() error {
    g.wg.Wait()
    if g.cancel != nil {
        g.cancel(g.err)
    }
    return g.err
}

g.semについては同時実行数を制限する際のプロパティのようですが、今回は同時実行数を制限していないので割愛。 やってることとしては、WaitGroupを使って実行数を管理する形でこれはgoroutineを実行する際のテンプレ的な使い方ですね。 g.errOnce.Doのところが複数起動中のgoroutineのうちどれかがエラーになったら他を止めるっていう肝で、一度エラーが発生したら、WithCancelCauseで冒頭に作っておいたcancel関数を実行し、紐づくcontextを全部止めに行ってるわけですね。 ほとんどがgoroutineの管理処理について書かれてますが、この「エラーがあったら他を全停止させる」っていうのがパッケージがerrgroupという名前の所以なのかもですね。

まとめ

今回は割とGopherさん向けの記事になってしまいましたが、こういう気づきを得たら定期的にブログに公開しようと思います。 最後までお付き合いいただきありがとうございました。
子育て中エンジニアが、限られた時間で開発を前に進めるために「ドキュメント中心のAI駆動開発」を試してみた話

はじめに

こんにちは、株式会社 kikitori の岩本です。
子供が生まれてから育児に携わる時間が増えてきたこともあり、限られた時間の中で効率よく業務を進める必要が出てきました。

そんな中で、新しい業務仕様やドメイン概念を扱う開発をAIと進めていると、

指示がうまく伝わらず何度もやり取りが発生したり、
途中で仕様のズレや認識齟齬が見つかる、
さらには責務分離や状態管理が後から崩れるといった問題が起きやすく、
結果的に「後で直す時間」が増えていました。

そこで最近は「AIが迷わない状態を先に作る」ことを重視し、
ドキュメントを中心にしたAI駆動開発を試しています。

結論

やっていることはシンプルです。

仕様確認
 ↓
設計
 ↓
ドキュメント化
 ↓
AIと設計レビュー / 実装プラン整理
 ↓
実装

ポイントは「仕様だけ」ではなく「設計」まで先に整理することと、
「いきなり実装させる」のではなく実装プラン整理を行い、認識が揃った状態で実装へ進めることです。

なぜ設計まで含めてドキュメントを記載するようにしたのか

最初は仕様だけをドキュメント化し、それをAIへ渡して実装してもらう形を取っていました。 プロンプトで都度仕様を説明するよりも、仕様の全体像を共有しやすかったためです。

ただ実際にこの形でAIに実装させると componentにロジックが集まったり状態管理が肥大化したり、ドメイン知識がUIへ漏れたりしたということがありました。 これはAIの特性を考えると自然な挙動だと思っています。

AIは仕様から動くコードを生成することは得意ですが、設計上の判断が必要な場面では複数の選択肢の中から「もっともそれらしいもの」を推測して実装します。

そのため、設計意図を明示していない部分については、責務分離や状態管理の方針が意図と異なる形で実装されることがありました。

この問題を防ぐために、最近はコード生成の前に「AIが推測しそうな部分」を先に設計として整理するようにしています。

実装前には実装プランを確認

また、ドキュメント量が増えると、AIが一部の情報を見落とすこともあります。
そのため、ドキュメントを読み込ませた後に一度実装プランを整理してもらい、設計意図とのズレがないかを確認するようにしています。

実際に試してみると、この段階で認識のズレが見つかることも少なくありません。

コード生成に入る前に設計レビューを行うイメージで、AIがどのように仕様を解釈しているかを確認しています。

実際に作っているdocs

現在は以下のような構成で整理しています。

docs/
  00_overview.md
  10_ui.md
  15_ui_logic.md
  20_api.md
  25_api_logic.md
  30_domain.md
  40_tests.md
  50_checklist.md

それぞれのドキュメントには役割を持たせています。

例えば、スコープ定義は 00_overview.md、UI仕様は 10_ui.md、API契約は 20_api.md のように責務を分けています。

また、実装時に迷いやすい UI内部設計やAPI内部ロジックは別ファイルとして切り出し、テスト観点やレビュー観点も独立して管理しています。

この後それぞれ抜粋して詳細を説明します。

1. 最初にスコープを固定する

最初に00_overview.mdにて、何をやるかと何をやらないかを固定します。

## 対応する
- 一覧画面
- 登録処理
- 編集処理

## 対応しない
- 外部連携
- バッチ処理
- 帳票出力

これを先に決めることで、
AIがスコープ外の実装まで広げてしまうことを防ぎやすくなりました。

2. UI仕様とUI内部設計を分ける

次に10_ui.md、15_ui_logic.mdにて、
画面仕様だけでなく、内部設計も別docsへ分離しています。

まず10_ui.mdで、

# 10_ui.md
- 画面構成
- 表示要件
- バリデーション

といった画面仕様をまとめ

# 15_ui_logic.md
- component責務
- state管理
- データフロー
...など

ロジック部分を整理しています。

当初は画面仕様と内部設計を同じドキュメントにまとめていました。 しかし仕様が複雑になるにつれて、画面要件と実装方針が混在し、AIへ意図を伝えづらくなることがありました。

そのため現在は、「何を表示するか」と「どう責務を分けるか」を分けて整理しています。

3. API契約と内部ロジック・ドメイン知識を分ける

APIでも同じです。

20_api.md、25_api_logic.md、30_domain.mdにて、
契約・内部処理・ドメイン知識を分離しています。

まず20_api.mdでは、

# 20_api.md
- API一覧
- request / response
- 認可
- エラー方針

などの「外向き仕様」を整理します。

次に25_api_logic.mdでは、

# 25_api_logic.md
- save/update/delete判定
- transaction範囲
- validator責務

など、内部ロジックを整理します。

さらに30_domain.mdでは、

# 30_domain.md
- entity間の関係
- 業務ルール
- 集約単位
- 用語定義

など、実装前提となるドメイン知識を整理しています。

API側も当初は契約と内部ロジックをまとめて整理していましたが、 契約と内部ロジックが混ざり、AIも責務を誤って解釈することがありました。

そのため現在は、契約・内部ロジック・ドメイン知識を分離して管理しています。

4. テスト計画とコード品質担保もdocs化する

実装だけでなく、どこまでテストするかやどの観点をレビューするか など品質面も docs 化しています。

例えば40_tests.mdでは、

# 40_tests.md
- server / UI の最低確認観点
- fixture方針
- PRフェーズごとの test 方針
- 実行確認内容

などを整理しています。

また50_checklist.mdでは、

# 50_checklist.md
- Plan Gate(実装前確認)
- Policy Gate(設計・実装中確認)
- Verify Gate(実装後確認)

という形で、
設計崩れや確認漏れを防ぐためのチェックリストを定義しています。

実際には、AIにテストコードを生成させると、実装に強く依存したテストになり、 ユースケース視点での確認観点が抜けることがありました。

また、過去のレビューで繰り返し指摘された内容もあるため、 テスト観点やレビュー観点も事前にドキュメント化しています。

実際に感じた効果

この進め方を取り入れてから、 以前よりも「どこが意図とズレているか」にかなり早く気づけるようになりました。

もちろん、AI実装の修正が不要になるわけではありません。

実際には、命名調整や責務見直し、ドメイン整理、将来拡張を踏まえた再設計 などは普通に発生します。

また、docs作成自体にも一定のコストがかかるため、
小さい修正ではオーバーになるケースもあります。

ただ、限られた時間の中で開発を進める上では、「後から大きく設計が崩れる」「どこが問題なのか分からなくなる」 といった状態を減らせるだけでも、かなり進めやすさが変わると感じています。

そのため最近は、「コード生成そのもの」より、
「設計とレビュー観点を先に整理すること」に価値を感じています。

まとめ

AI駆動開発では、「何を作るか」だけではなく、「どう責務を分けるか」「どういう構造で作るか」 まで整理しておくことがかなり重要でした。

特に、設計要素やドメイン理解が重要な開発ほど、この進め方の効果を感じています。

まだ試行錯誤中ではありますが、今後も改善を続けていきたいと思います。

また、kikitoriでは社内でも「AIをどう開発に活かしていくか」について日々模索し、共有しながら改善を進めています。

AIも活用しながら、農業流通業界へ価値を届けていきたい方がいましたら、ぜひお気軽にお話しできると嬉しいです。


We're hiring!

kikitoriでは事業拡大に伴い、一緒に働く仲間を募集しています!

ご興味ありましたら、ぜひお気軽にエントリー・面談をお申し込みください。 お待ちしております!

careers.kikitori.jp

Anthropic から新しくリリースされた Claude Design は何であり、何が新しいのか

Anthropic から新プロダクトがリリースされた!

こんにちは。株式会社 kikitori の CTO の永谷です。 Anthropic Labs から新プロダクトの Claude Design がリリースされました。 率直に言って、文句のつけようのない素晴らしいプロダクトで、久しぶりに驚きしかなかったので、本来月次のテックブログですが、記事を書いてしまいました。

公開初日からレビュー記事は大量に出ていますが、その多くは AI 生成と思しき、心のない記事ばかり...(最近このパターンが本当に多いですよね)。 せっかくなので、一度触ってみた人に向けて、人の言葉でこの驚きを残しておくのとともに、Claude Design の本質に迫ってみたいと思います。 まだ触っていない方は、読む前にまずサービスを開いてみてください!

Claude Design の位置づけ

まず Anthropic のプロダクトポートフォリオにおける Claude Design の位置づけを整理してみたいと思います。あくまで推測ではありますが、概ね間違っていないはずです。

  • Claude Code: Claude のエージェントとしての能力そのもの。すべての核。
  • Claude Cowork: Claude Code の能力を VM で包み、技術者による監視なしで安心して走らせられるようにしたプロダクト。
  • Claude Design: Claude Code の能力に、フロントエンド開発のワークフローに必要なツール群を付加したプロダクト。

つまり Claude Design は、単独の新プロダクトというより、Claude Code という核に対する、フロントエンドドメイン特化のインターフェースと見るのが自然です。

なぜ Anthropic が「デザインツール」を作ったのか

「SaaS is dead」が叫ばれる中で、Anthropic がデザインツールにプロダクトポートフォリオを拡張した理由はどこにあるのか。 Claude Cowork の場合は「VM によるアイソレーション」という、汎用エージェントでは出せない価値が明快でした。 では Claude Design の強みは何になるのでしょうか。

この理解のため、まずはフロントエンド開発のワークフローを分解して考えてみましょう。

  1. コードを書く
  2. 作ったデザインを表示する
  3. エンジニアが画面を見てレイアウトを調整する
  4. ステークホルダーが成果物にフィードバックする(以下繰り返し)

Claude Design は、技術的には Figma Make や v0 と同じ「フロントエンド自動開発ツール」の系譜です*1。

しかし多くの競合は 1 と 2 までしか対応しておらず、実用レベルのクリエイティブを作成する能力には限界がありました。そして正直なところ、1 と 2 だけなら Claude Code などの汎用 AI エージェントとローカル IDE によるライブプレビューの方が快適です。私がこの類のツールの使用にこれまで消極的だったのは、これが原因でした。

つまり、3 と 4 にどこまで踏み込めるかが新規サービスとしての価値の分かれ目となることになります。驚くべきことに、Claude Design はここに対し、まさに 100 点満点*2の回答を用意してきました。

3. エンジニアによるレイアウト調整 → 自己フィードバックループで解決

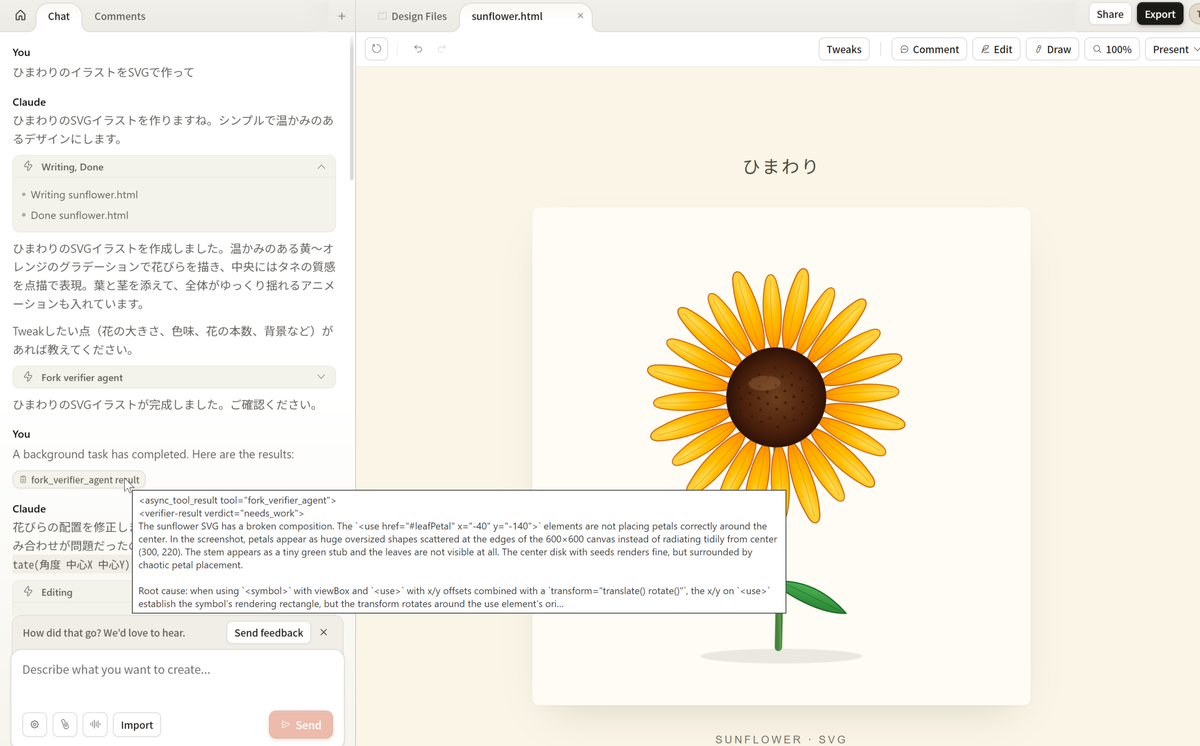
Claude Design は、生成物のスクリーンショットを自ら入力として読み直し、マルチモーダルでレイアウトの崩れを検出・修正する、という自己フィードバックループを備えています。シンプルな機構ではありますが、この機能の有無による成果物の品質の差は絶望的なほど大きいです。

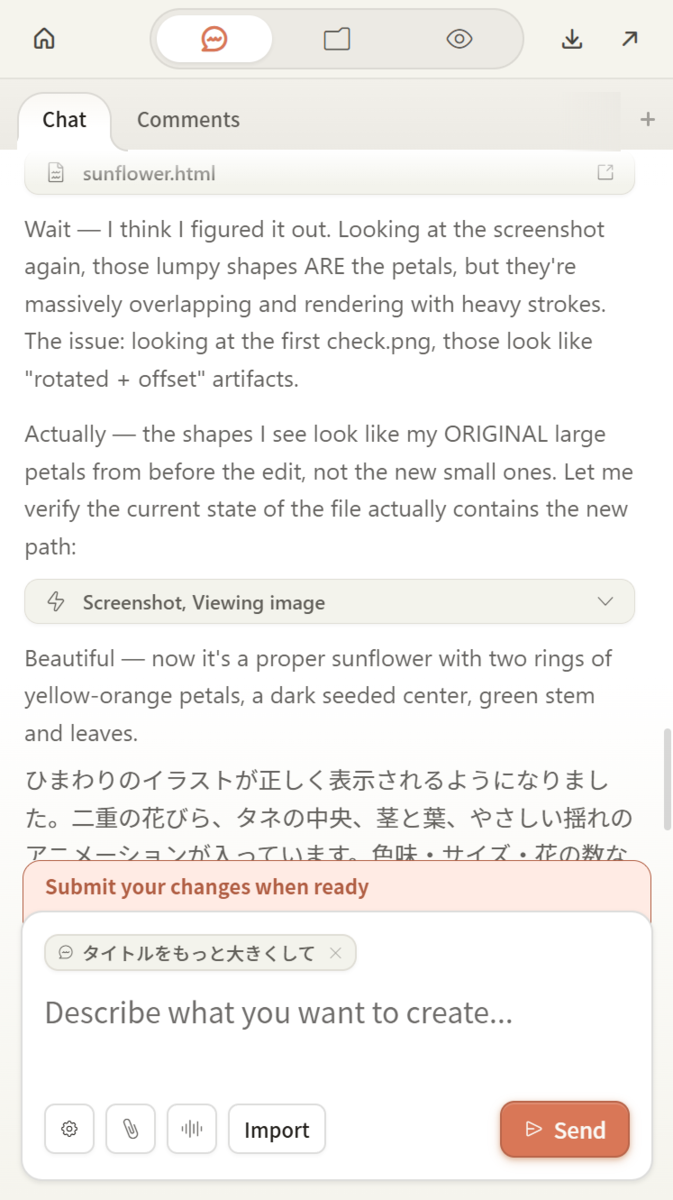
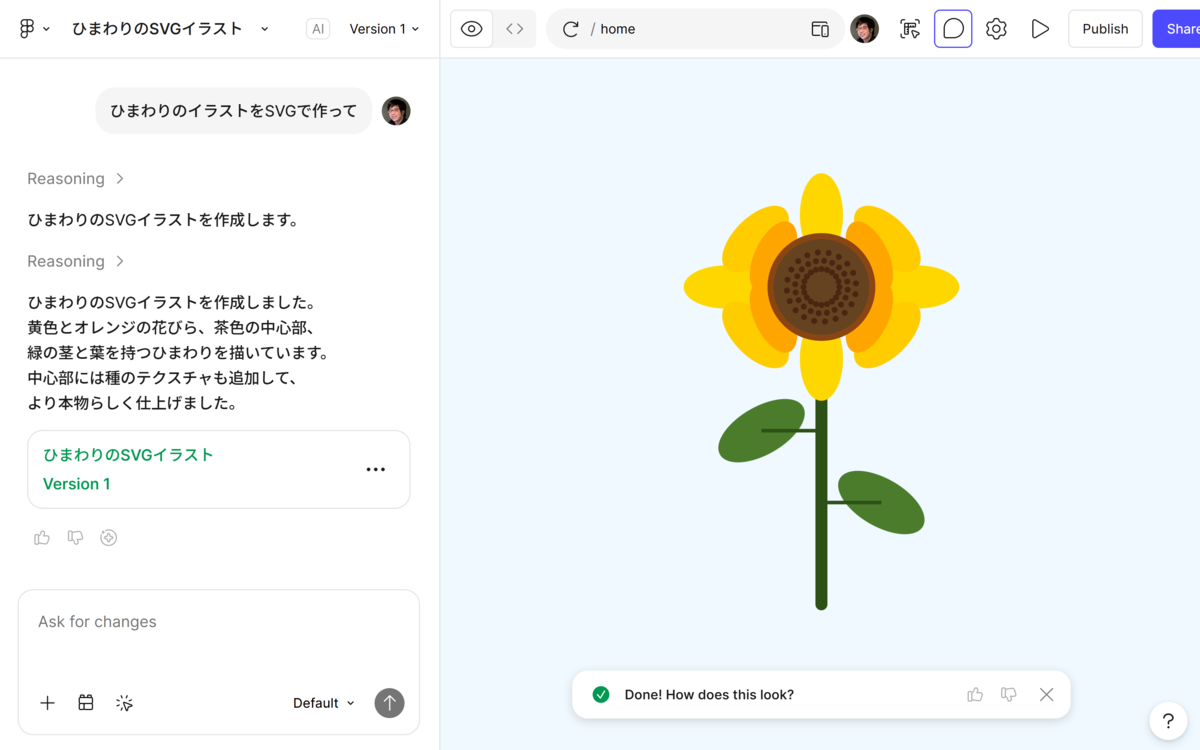
実際に、Figma Make と Claude Design に対し、「ひまわりのイラストを SVG で作って」といった単純なプロンプトを投げてみましょう。結果は下図の通りです。

Figma Make でのひまわりのイラスト作成

Claude Design でのひまわりのイラスト作成

Figma Make は一発の生成で終わるのに対し、Claude Design はドラフトを作った後、「実際に目で見て」レイアウトを詰めてくれます。この例でも、最初はイラストとしては茎と花が分離していて崩壊していたのですが、自分でそれに気づいて修正が行われました*3。結果、Claude Design のイラストは、本当にイラストレーターが描いたようなイラストになっています。

この仕組みは一見当たり前に見えますが、実装上の制約を考えると、スクリーンショットの取得と再評価はトークンを大量に消費するため、簡単には提供できません*4。

自社モデルを持たない Figma のような企業が、1 ライセンス $20 程度で提供するには、コスト構造的に提供が難しい機能だと思われます*5。自社でモデルを持つ Anthropic だからこそ、ここに踏み込めたのでしょう。Claude Code でも同様の仕組みを構築できはしますが、難しい設定なしでブラウザのみで実行できる点は、とても魅力的です。

4. ステークホルダーからのフィードバック → 圧倒的に使いやすい UI で解決

Claude Design はデザインに対するユーザーからのフィードバックを得るための仕組みとして、2 種類の機能を提供しています。

ひとつは、CSS とテキストのインライン編集です。レイアウトレベルのカスタマイズはできませんが、WebFlow のようにテキストだけでなくスタイルもその場で直接編集できます。「色をもう少し柔らかく」とチャットに書くより、スライダーを動かす方が圧倒的に早い場面は多いため、成果物の最後の編集のために非常に役立ちます。

もうひとつは、AI への直接のフィードバックになります。これには、2つのモードが提供されています。

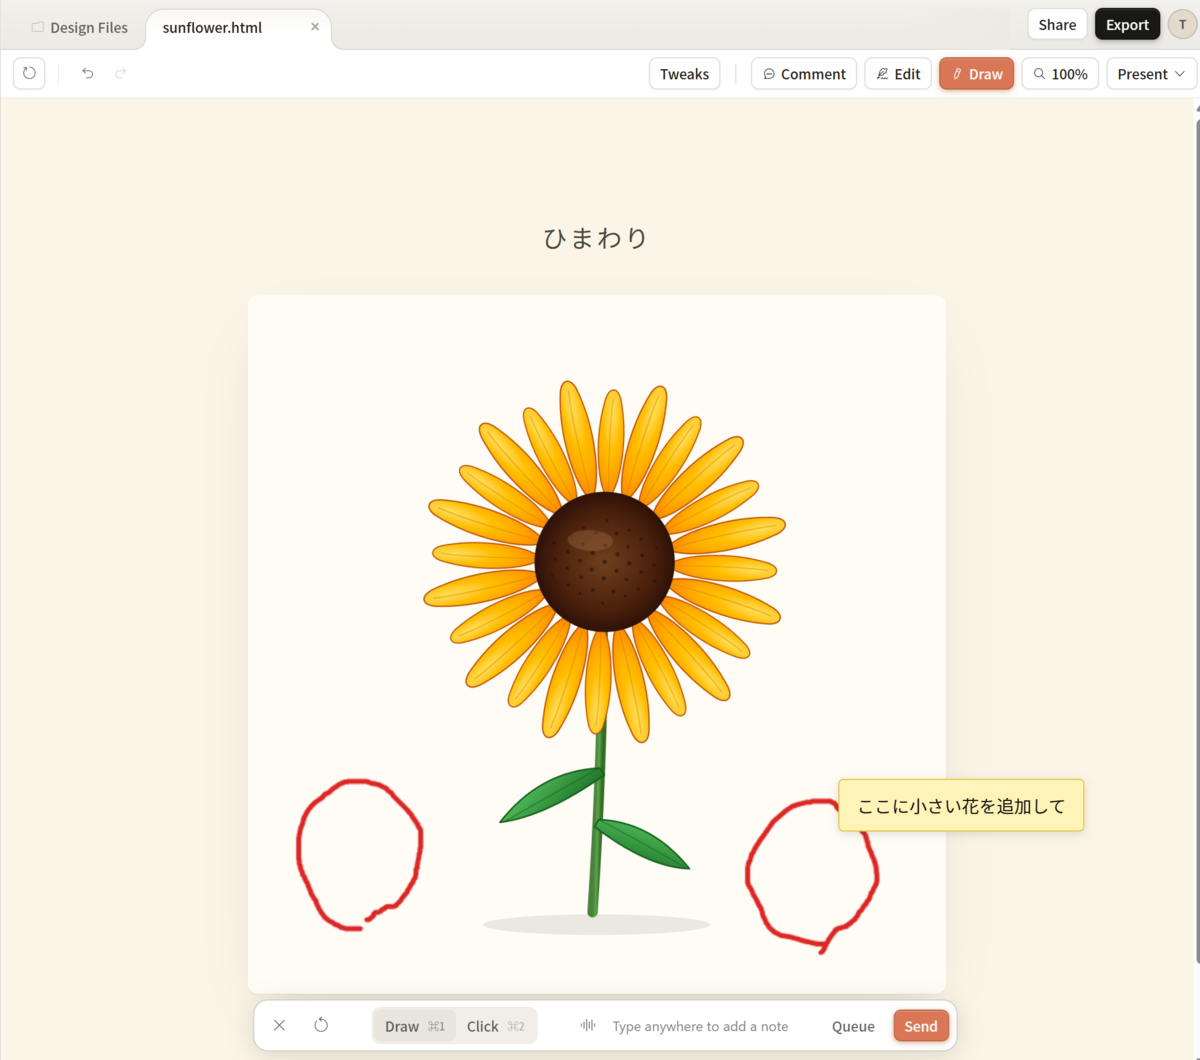
  • ① DOM レベルでの精度の高いコメント。要素を直接指し示した上でメッセージを送信する。
  • ② 座標ベースのコメント+手書きの指示。DOM を気にせず紙に赤ペンでマークするようにラフに指示できる。

UX としても、「Edit(直接編集)」「Comment(DOM を指定してフィードバック)」「Draw(絶対座標でフィードバック)」というわかりやすいメニューになっており、背景知識のないユーザーでも直感的に使えるようにデザインされています。非技術者であるステークホルダーが成果物に直接フィードバックを返すことも容易でしょう。

Draw モードでフィードバックをする様子

ここは、エンジニアリングパワーがものを言う領域です。①には WebFlow のような DOM 操作の精度が、②にはラフな指示を正しく解釈する UX 設計が要求されます。

総じて、これら 3 や 4 の機能群は、「ロードマップとしては競合も検討していたが、他社はコストとエンジニアリング能力の両面で実現できていなかった」という類の機能だと思われます。

Anthropic の強さの源泉

触っていて、Anthropic という企業の強さを三つの側面から改めて感じました。

AI プロバイダーとしての戦略の一貫性

AGI という遠い夢を追う OpenAI とは対照的に、Anthropic は 「現在の AI の能力の下で実用的に成立するエージェンティックなユースケース」に一貫してフォーカスしています。トークン課金もすべてのツールで共有されており、課金体系も明快です。返答のトーンも、会話の楽しさよりも実用性に重きを置いています。派手さはないですが、ビジネスとして信頼を寄せやすいです。

プロダクトポートフォリオの巧みさ

Anthropic のプロダクトは、見渡すといずれも「本質的にプロダクトとして提供すべき領域」 を突いてきます。単なるきれいなラッパーや AI ガワのツールではなく、明確なビジョンの下で必要な位置に必要な駒を置いています。一方で、ビジョン先行で終わらず、マーケットが実際に求めているものとの整合性があり、企業価値も着実に積み上げ、理想と市場の双方からプロダクトを組み上げていると感じます。

エンジニアリング組織の強さ

CTO としては、やはり一番気になるところです。Claude Design は、リリース当日から Figma Make や v0 に対して完成度の面で明確な差がついていました。Cowork のときも同様で、macOS や Windows の仮想環境の存在を意識させないレベルの体験が、リリース当日から提供されていました。

普通のプロダクト開発では、MVP と称して機能 1〜3 くらいで見切り発車するのが合理的な判断です。私だったらそうすると思います。しかし、Anthropic は、マーケットへのインパクトを優先して完成度を高め切ってからリリースすることで、意図的に「衝撃」を演出しています。これは、リリースが後ろ倒しになり、競合に先行されるリスクを飲み込めるだけの、圧倒的に強力なエンジニアリング組織が背景にないと戦略として成立しません。

また、開発者ツールを見る限り、Claude Design のフロントエンドは React Router + styled-components という保守的で堅実な技術を使用しています。Anthropic の他のプロダクトも同様なのですが、派手な技術ではなく、枯れた技術で高い完成度を出してくる、成熟したエンジニアリング組織であることが推察されます。

当社はこの AI のビッグウェーブにどう向き合うか

Claude Design に触れることで、改めて Anthropic のような組織の偉大さを再認識しました。 そして、当社 kikitori としては、この AI ムーブメントは、当社の価値を毀損するというより、むしろより当社の価値を最大化するものであると感じます。これは単純なポジショントークというよりも、実際にプロダクト開発の現場に携わる者としての実感です。

当社では、農業流通の現場で使われるプロダクトを作っています。現場がどう動いているのか、何が必要で何が制約になるのか、こういった情報を日々全国から収集し、判断し、プロダクトへと反映しています。現場になくてはならないプロダクトは、AI 時代にも引き続き必要とされ続けるのだと考えています(Anthropic が Claude Design を作ったのと同様です)。

また、当社の nimaru は、日本の農産物流通現場で最も多く使われているプロダクトだと自負しています。全国から、大量の流通データが日々 nimaru の中に蓄積されています。今後は、こうしたデータを活用しながら、プロダクトの今後の戦略を考えていくことになります。

この二つの理由から、私たちは、農業流通という領域で圧倒的な価値を出せるのは当社だけだと本気で考えています。流通の未来をリアルに描きながら作っていくのが楽しいと感じる方、ぜひ当社への応募を、お待ちしています!

herp.careers

おまけ: すごいよ Claude Design

リリース初日でこのクォリティというのに驚きが隠せません・・・

Edit 機能

Comment 機能

プレゼン資料として表示する機能

エクスポート機能

Figma や GitHub、独自デザインシステムとも接続できる

全画面レスポンシブ対応

アニメーションも作れる

UI プロトタイプ、スライドを作る機能が標準搭載

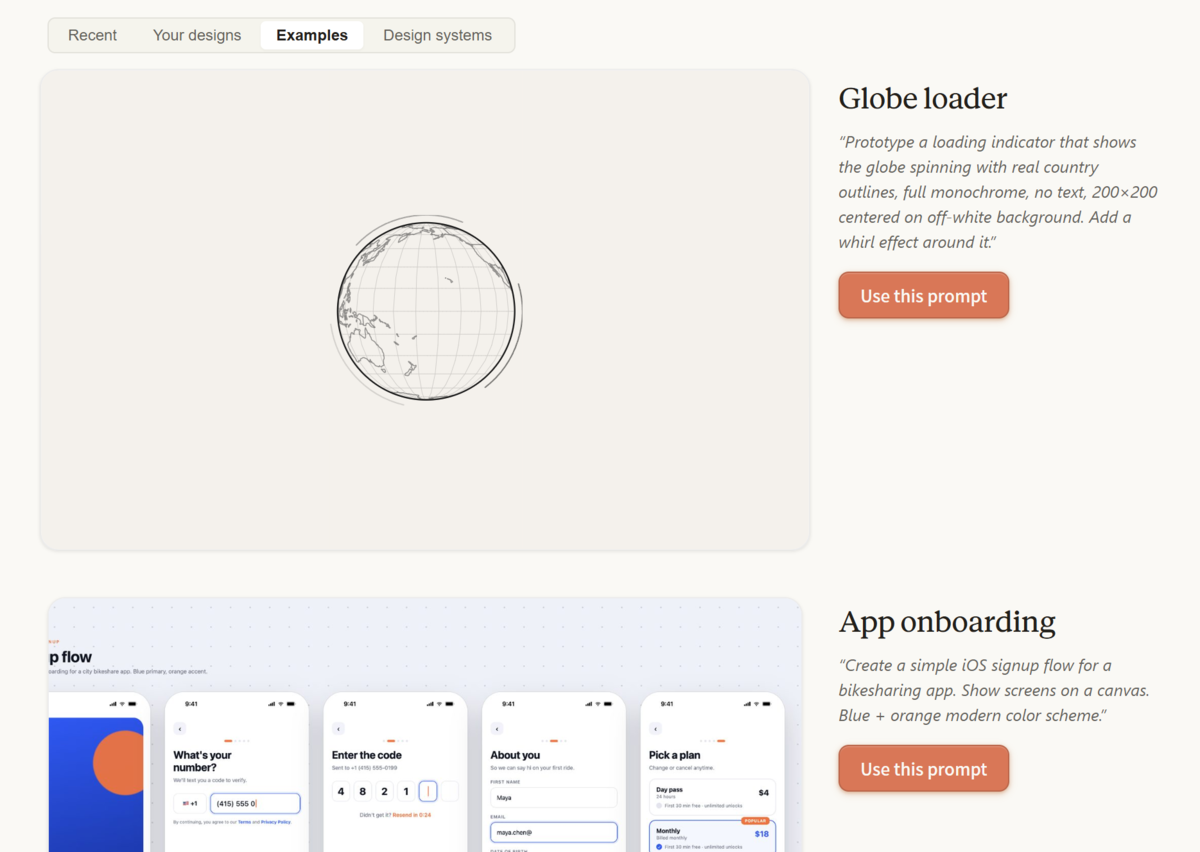
ギャラリーも充実

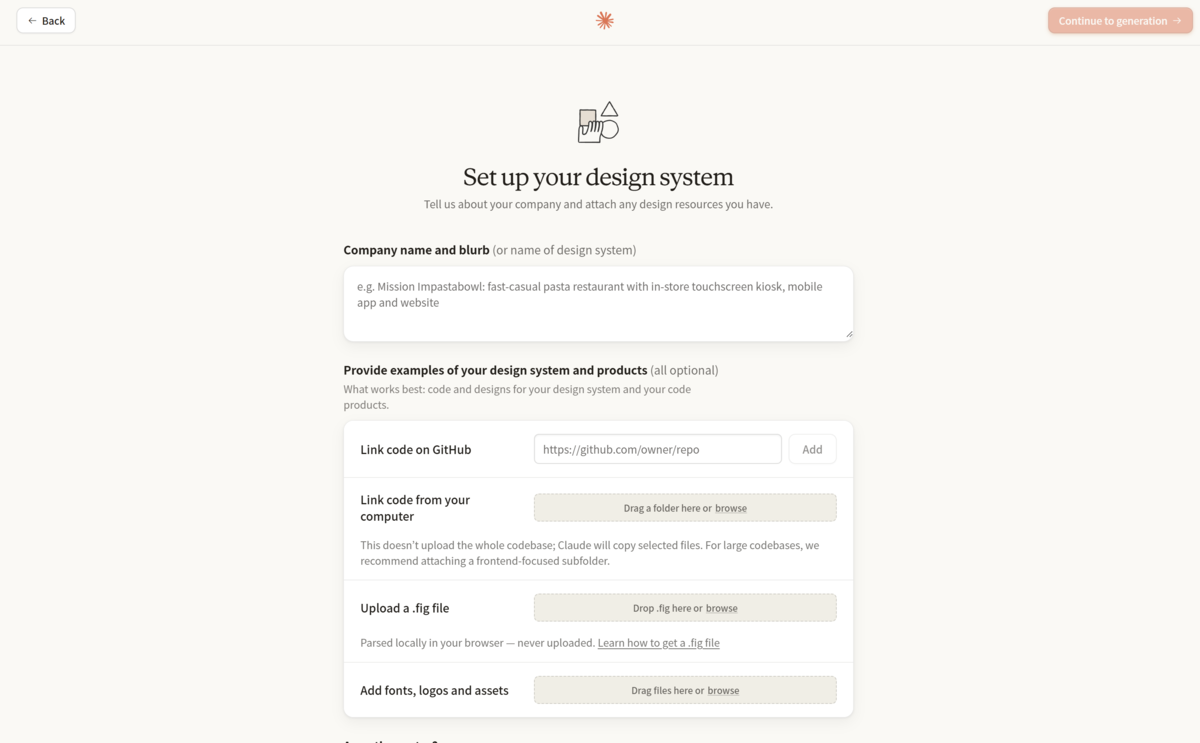
デザインシステムをインポートする機能も搭載

しっかりした GitHub インポート機能

herp.careers

*1:フロントエンドエンジニアというよりはデザイナー向けのツールとしてのポジションですが、生成されたコードなどの技術的詳細は露出されています。

*2:以前社内で、Figma Make などのプロトタイピングツールに対して「こういう機能があったらいいよね」という会話がありました。Claude Design はその期待を軽々と超えてきました。

*3:このフィードバックの生成はバックグラウンドで行われ、利用者はそれを待たずにどんどん次の指示を出すことができます。また、スクリーンショットを見ていただければ分かるように、処理は Claude Code でおなじみのサブエージェントによって実行され、コンテキストを圧迫しないようになっているようです。こういった、ストレスを感じさせない細かい UX の作りこみも流石だと感じます。

*4:実際に、Max ではなく Pro プランで実行すると、あっという間にモデルの制限に達しました。

*5:直近では AI による高度な機能を提供するため、AI の利用量に応じたクレジットを導入する動きが広がっています。実際に、Figma や Notion などでは、AI クレジットが別途課金対象になりました。

Sentry を障害検知ツールとして生まれ変わらせるまでの軌跡

こんにちは、株式会社 kikitori の小川です。

kikitori で開発している農業流通分野特化型 SaaS 「nimaru」 はローンチから5年以上経過し、当初と比較すると様々な機能が追加され全国様々な事業者に使用されるまでに至りました。ただし利用者が増えたことで nimaru に障害が発生すると影響を受けるユーザーも増えることとなり、発生した際の早期検知/早期対応の必要性が高まっていました。

nimaru にはローンチ当初から Sentry を導入しており、nimaru でエラーが発生すると Sentry がキャッチし、専用の Slack チャネルに通知が送られる仕組みが整っていました。しかし Sentry がどんな軽微なエラーでもキャッチし通知を送信していたため膨大な数の通知が送られ、他の通知に埋もれ重要なものに気付けないことがありました。そのため障害の検知ツールとしては活用しきれず、障害発生の報告を受けた際にエラー内容を確認するためのツールとして使われてきました。

今回はそんな狼少年となってしまった Sentry を障害検知のツールとして生まれ変わらせるまでの軌跡をまとめました。

目的設定

kikitori の開発チームはまだまだ少人数ということもあり、運用の体制が仕組みとして整備されていませんでした。 そこで少人数でも運用を回せるようにするために、まずは現在 Sentry から送られてくる膨大な通知を重要度が高いものに限定することで障害をいち早く検知することを目的としました。

ただ重要度が高いものに限定するといっても重要なエラーだけを通知対象に指定する方法では事前に「重要なエラーとは何か」を定義する必要があり、また定義から漏れた想定外のエラーには対応できないため広範な障害検知には向きません。そこで逆のアプローチとしてエラーとして検知されたが問題はない、偽陽性といえるエラーを通知対象から除外していくことで結果として比較的重要度が高いエラーについてのみ通知される状態を目指すこととしました。

既存エラーを Archive 化

まず Sentry ではキャッチしたエラーを通知対象から除外する Archive 機能 があったのでこちらを活用することにしました。これは任意のエラーを通知対象から除外してくれる機能で、一定の回数/期間を超過するまでは通知しないといったような設定が可能となっています。

今回は既知のエラーを Archive Until Escalating に変更することで一度全て通知対象から除外することとしました。これは通知対象外にはするものの同じエラーの件数が大幅に増加したと Sentry が判断した場合には再度通知されるようになるものです。 この時に Archive したエラーに重要なエラーが含まれている可能性もありましたが、この時点では Sentry からの通知を活用できていなかったこと、Archive したエラーに起因する障害が発生したとしても Archive Until Escalating であれば再度通知が行われることを期待してこのような対処としました。

これにより 1日に数十件あった通知を数件まで削減できました。

特定のエラーを除外

通知件数は大幅に減ったものの通知されるエラーは依然として偽陽性といえるものばかりであり、毎日何件も高確率で偽陽性である通知を確認し続けるのは他の作業の妨げになっていました。

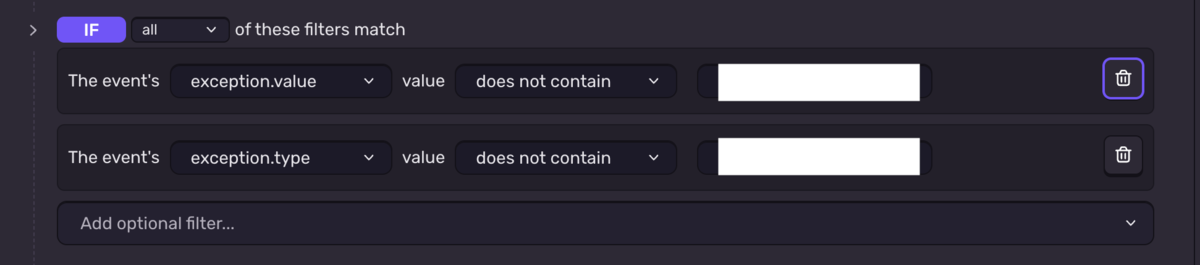
そこで通知されるエラーの内容を分析したところ、不正な入力値を検出して処理を中断したことを示すエラーがありました。 これはデータの整合性を保証するために生じたもので、正常なアプリケーションの動作といえるものでした。こういった明らかに偽陽性だと判断できるエラーのパターンについても通知の対象から除外していきました。 幸いエラーメッセージに規則性があり、それに基づいたパターンでの検出が可能だったので、通知設定にエラーメッセージの値によるフィルタを追加して通知対象から除外しました。

また、その他のエラーについても対応が不要なものについては Archive Until Escalating にすることで通知件数の抑制を続けました。

この対応を追加したことで通知件数を 1日に数件から 1週間に数件まで削減することができました。

頻度調整

ここまでの対応で当初と比較すると通知されるエラー件数は激減しましたが、依然通知されるのは偽陽性といえるエラーばかりで、あと一歩の削減策が必要になりました。

偽陽性といえるエラーの傾向を観察したところ、ほとんどが新規かつ単発のものであり、継続して複数回検出されるものはありませんでした。そこで 通知設定に発生頻度の条件を追加し同じ種類のエラーが一定回数以上発生した時に通知されるよう設定しました。

どれくらいの頻度にするべきか少し悩みましたが、対象期間を長くすると通知の削減効果が得られないこと、また通知させたくない偽陽性のエラーは単発のものばかりだったことを踏まえてひとまず 1日に 2件以上発生したら通知するよう調整しました。

これにより一度限りのエラーについては通知されないようになりましたが、同時に重要なエラーであったとしても 2回以上発生して初めて通知を受け取ることになるので即応性は若干下がるリスクも同時に抱えることにはなりました。 ただ正常な操作ができないとなればユーザーは再度試すと想定し、いざ障害が発生すれば同種のエラーは 2回以上発生するだろうと考え、このリスクを許容することにしました。

そして発生頻度の設定を追加してから 2週間が経ちますが、この間に新たな Sentry からの通知は 1件も来ておらず、またユーザーからの障害報告もないことから重要なエラーの発生も見逃しも起きずに経過できています。

まとめ

長い間活用されていなかった Sentry ですが、ようやくその力を発揮してもらえるようになりました。

今回はエラー通知を削減するにあたり、消去法的に通知対象を絞り込む方法を取りました。この方法であれば未知のエラーも通知対象に残るため、ひとまず上手くできたのではないかと思います。

逆に発生してほしくない、クリティカルであると事前に特定できるエラーについては通知対象をピンポイントで指定するアプローチが有効になります。

Sentry は複数の通知ルールを併用できるので、1つのルールで無理に全体をカバーしようとするのではなく、検知したい対象によってルールを使い分ける方が柔軟な運用ができると思います。

最後に

kikitori では nimaru を一緒に開発/全国に展開していくメンバーをまだまだ募集しています。 少しでも興味がありましたら、お気軽にエントリー・面談をお申し込みください。

https://careers.kikitori.jp

農業現場の非構造データと向き合った話

こんにちは。株式会社kikitoriの大木です。

kikitori では JA や卸売市場向けの SaaS 「nimaru」を開発しています。

農業現場には、そのままだとシステムで扱いにくい情報が多く、どう取り込めばよいか悩むことが多々あります。

今回は、生産者の方が栽培記録をつける際に使用する「農薬登録情報」を取り上げます。

ドメインとしては少し特殊ですが、同じような構造化しづらいデータに向き合っている方の参考になれば嬉しいです。


農薬登録情報とは

農薬のボトルなどに記載されている、適正な使用に関する基準のことです。

テマカットフロアブルのボトル

参照: 農薬ラベルの読み方 | 日本農薬株式会社

この使用基準は、農林水産省所管の独立行政法人である 独立行政法人農林水産消費安全技術センター(FAMIC) が公開している登録情報に基づいています。

使用基準には、こういった情報が含まれています。

  • 使用量(例:10kg/10a)
  • 希釈倍数(例:1000倍)
  • 使用時期(例:収穫前7日まで)
  • 本剤の使用回数(例:本剤3回以内)
  • 使用方法
  • 有効成分ごとの回数制限

nimaruでは、生産者やJA職員の方が基準に沿って農薬情報を扱えるように、この登録情報を取り込んで適正使用の判定に活用しています。

一見シンプル、でも扱いが難しい

使用基準は、一見するとシンプルに見えます。

  • 使用量は 8〜10kg/10a の範囲に従って使用する
  • 使用時期は 収穫前7日まで
  • 栽培期間における使用回数は 3回以内
  • 原液の希釈倍数は 1000倍

数値もあり、条件もはっきり書かれているため、最初は「パターンを抽出してパースすればよいのでは」と考えていました。

しかし調べていくうちに、難しさが見えてきました。

  • 単位が揺れている(kg, g, mL, ppm など)
  • 希釈倍数と使用量が、1つの項目にまとめて書かれている
  • 但し書きや例外が途中に入っている(「ただし施設栽培の場合を除く」など)
  • 基準は不定期に改訂される

農薬登録情報は法令に基づく情報なので、誤った取り扱いは重大な問題につながります。

パターン抽出だけでは安全に扱えないことが分かってきて、どう構造化するかを本格的に考え始めました。

ユーザーに基準を設定してもらう方式

最初に考えたのは、登録情報の解析は入力補助にとどめて、最終的な判定基準はユーザーに設定してもらう方式です。

農薬登録情報
↓(簡易パース)
入力補助
↓
ユーザーが基準を設定
↓
システム判定

この方式なら、判定ロジックはシンプルになります。

基準をユーザーが設定するので、どの条件で判定しているかも分かりやすくなります。

ただし、実際の運用を考えると課題がありました。

現場では数十から数百種類の農薬を扱うこともあるので、それぞれに基準を手で設定するのは手間がかかります。

また、登録情報は不定期に更新されるので、そのたびに設定を見直す必要も出てきます。

安心感はありますが、本番運用をするには難しい構成でした。

どこまで構造化できるか

次に考えたのは、ラベルの文言を機械的にパースして、判定に使える形にする方法です。

  • 数値を抽出して min / max にする
  • 「◯回以内」を整数にする
  • 「収穫前◯日」を基準イベントからの相対日数にする

機械的に読み取れる部分は、このように構造化できます。

ただし、全部を同じように扱えるわけではありませんでした。

  • 表記揺れ(「10aあたり」「10a 当たり」など)
  • 条件付きの例外
  • 1つの基準の中に含まれる複数の条件
  • 曖昧な但し書き

機械的に扱える部分と、人が読まないと分からない部分が混ざっていました。

この状況をCTOに相談して、パースできる範囲とできない範囲を分ける方針になりました。構成の大枠や詳細はCTOに、自分からは現場のデータの実態を共有する形で詰めていきました。

Raw と Parsed を分けて持つ

採用したのは、Raw(原文)と Parsed(解析済みデータ)を分けて持つ構成です。

同じ項目でも、Raw は原文をそのまま文字列で持ち、Parsed は機械的に扱える形に変換しています。

構造化できる例

項目 Raw(原文) Parsed(解析後)
使用量 8〜10kg/10a min: 8, max: 10(数値の範囲)
希釈倍数 1000倍 min: 1000, max: 1000
使用時期 収穫前7日まで 基準: 収穫日, 日数: -7
使用回数 3回以内 3

構造化できない例

項目 Raw(原文) Parsed
使用量 <床土・堆肥>1穴当り3mL<圃場>1穴当り2~3mL 解析しない
使用時期 3~5月株養成期 解析しない

画面表示には Raw、判定には Parsed を使うことで、ユーザーが見る情報とシステムが使う情報を分けています。

構造化できない基準には「要確認」のフラグを立てて、自動判定ではなく意思表示で確認する形式にしました。

曖昧なまま自動判定を行わない、というのがこの設計の意図です。

自動判定を行わない場合の作業登録画面

どこまで自動で判定するか

この構成により、「自動で判定するもの」と「人が確認するもの」を分けられるようになりました。

自動で判定するのは、数値や日付のように機械的に扱えるものです。

  • 数値の範囲チェック
  • 使用回数の累積チェック
  • 使用時期の相対日数の計算

一方で、基準のなかには機械的に扱いづらいものもあります。

そういったものは無理に自動判定を通さず、適正使用の意思表示で確認できるようにしています。

  • 曖昧な但し書き
  • 想定していない単位
  • 条件付きの例外

この線引きがあることで、生産者の方やJA職員の方にも「ここはシステムが見ています」「ここはご自身で確認してください」と伝えやすくなりました。

おわりに

今回のケースでは、全部を自動化しようとせず、機械的に構造化できる範囲と人が判断する範囲を分けることが重要なポイントでした。

非構造な情報をシステムで扱う場面で、何かの参考になれば嬉しいです。


We're hiring!

kikitoriでは事業拡大に伴い、一緒に働く仲間を募集しています!

ご興味ありましたら、ぜひお気軽にエントリー・面談をお申し込みください。 お待ちしております!

careers.kikitori.jp

プロダクトマネージャーとしてMagicPodを活用し、品質向上に取り組んでいる話

はじめに

kikitoriでプロダクトマネージャーをしている兒玉です。
本記事では、プロダクトマネージャーである私が、MagicPodを活用してプロダクトの品質向上に取り組んだ(取り組んでいる)事例について紹介します。
QAエンジニアが不在で、少人数でプロダクトを開発・運営しているスタートアップやチームにとって為になれば幸いです。

開発チームとして直面していた品質課題

nimaruはPMF目前の状況で、ほぼ毎日リリースを行う体制を取っています。ありがたいことにお客様も日増しに増えており、BizとDevが日々高速に連携しながら開発・リリースを進めています。

最終的な品質担保については、基本的に実装者が責任を持つ形で進めていましたが、ある日PRの内容からは想像しきれない箇所で、お客様にとってクリティカルな機能が操作不能になる事象が発生することがありました。

ポストモーテムを実施する中で見えてきたのが、お客様の主要な操作を担保する仕組みが存在していないという課題でした。
そこでこのタイミングで、主要なE2Eテストを継続的に実施できる仕組みを構築する方針を取りました。

一方で、進行中のプロジェクト状況を踏まえると、新たに体制を構築したり、エンジニアのリソースを大きく割いたりするのは現実的ではありませんでした。
そこで、私自身が過去にエンジニアとしてE2Eテストツールの導入・運用を少し経験していたこともあり、今回はプロダクトマネージャーである私が主導して進める判断をしました。

なぜMagicPodを選んだのか

nimaruの主要機能として、集出荷機能があります。

この機能では、生産者はスマートフォンから「いつ・何を・どれだけ出荷するか」を事前に連絡し、職員はPC・タブレット・スマートフォンを使って、実際に集まった農産物を受け取り、出荷先ごとに仕分け(分荷)を行います。その後、最終的に出荷内容を確定し、市場や取引先へ出荷するための出荷連絡を行うことができます。

この操作フローは、プロダクトにおける最重要ユースケースの一つであり、この一連の操作をテストできることを必須条件としました。

加えて重視したのが、運用に手間がかからないことです。
ここで言う「手間がかからない」とは、非エンジニアでもテストケースの作成・メンテナンスを低工数で行えることを含みます。

この条件を満たす候補として、MagicPodとBrowserStackに絞り、両方の無料枠を利用して使用感を試しました。

BrowserStackは、画面操作を録画するだけでテストケースを作成できる点が非常に魅力的でした。一方で、生成されたテストケースの修正時に、裏側で生成されているコードを修正する必要が出てくる点に、長期的な運用面での懸念が生まれました。

その点、MagicPodでは同様の懸念がなく、テストケースの保守をコード修正に依存せず行えることが、選定の決め手となりました。

プレ導入期間の計測指標について

MagicPodは価格面で見るとBrowserStackよりも高額なため、いきなり本導入するのではなく、成果を計測しながら慎重に導入する方針を取りました。

具体的には、月契約で3か月間のプレ導入期間を設け、その後に年契約に切り替えるかの判断を行う形にしました。

そこで、プレ導入期間中は以下3点の基準で、毎月1回振り返りをしました。

保守工数(1か月あたりのメンテ時間)

  • 非エンジニア主体でも無理なく回せるか
  • 目標:5〜7時間以内
  • 「負荷が高くて回せない」状態にならないか

安定稼働性

  • UI変更がない限り安定して動き続けるか
  • テスト落ちが頻発しないか
  • テスト落ち時の対応工数が過度でないか

品質担保への実感

  • コア機能の自動実行によって、致命的なデグレを検知できているか

プロダクトマネージャー主導で進めた導入・運用の進め方

まず、MagicPod導入の目的をチーム全体で共有しました。
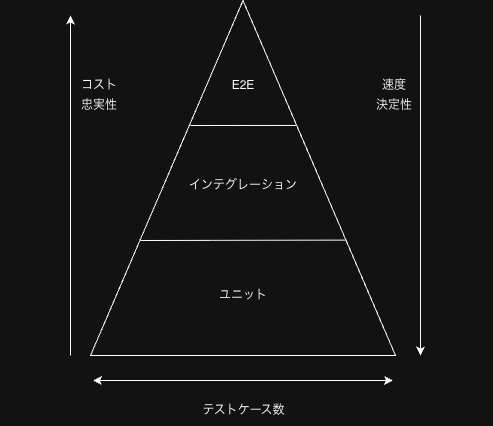
このテストがテストピラミッドのどこに位置づけられるのか、主要ユースケースに絞って自動化する理由、そして「メンテナンスを増やさない」ことを特に重視しました。

過去にエンジニアとしてE2Eテスト導入を進めた際、QA知見が乏しい状態でユニットテスト寄りの内容をE2Eで自動化してしまい、失敗した経験があります。その反省から、今回はここを強く意識しました。

テストピラミッド

次に、先輩プロダクトマネージャーを巻き込みながら、nimaruにおける主要ユースケースをユーザーシナリオとして定義しました。
プレ導入期間では、特に優先度が高い3つのユーザーシナリオを自動化対象としました。

幸い、過去の大きな改修時に使用していた手動テスト用のユーザーシナリオが存在していたため、それをベースに進めることができ、選定と定義に大きな時間を割かずに済みました。

テストケースの作成は、まずは私一人で行うことにしました。 また、テスト結果はSlackへ通知し、毎時の自動実行形にしました。

開発との連携としては、1時間に1回dev環境でMagicPodを実行し、テストが通っていることを確認したうえでリリースを行ってもらう運用にしました。

実際に導入・運用してみてどうだったか

2025年12月に初回の振り返りを行いました。

主要な成果としては、運用体制の構築や初期セットアップ、Slack連携の整備に加え、優先度が最も高いテストケースを作成し、安定的に稼働させられた点が挙げられます。

また、保守工数は月6時間程度に収まり、自動補正機能も有効に働いたことでテスト落ちはほとんど発生しませんでした。 これらの結果から、MagicPodは本導入に向けて十分に手応えのある指標を示していると感じています。

プロダクトマネージャー視点での課題とその打開策

1. テストケース作成にかかるリソース確保
現状は私一人が立ち上げを担っており、意識的に時間を確保しなければ進まないのが正直なところです。一方で、共有ステップ機能を活用してテストケースの部品化を進めたことで、以降のテストケース作成は徐々に効率化できています。実際に、1ケースあたりの作成時間は確実に短くなってきており、運用として現実的な手応えを感じています。

2. MagicPodの運用が属人化
テストケースの作成や運用を一人で担っているため、このままでは継続性やスケールに限界があります。その打開策として、本導入を見据え、テストが落ちた際には、その変更によって影響を与えたエンジニア自身が修正対応できるよう、簡易的なマニュアル整備を進めています。将来的には、私がすべてを抱え込むのではなく、チーム全体で品質を支える体制に移行していきたいと考えています。

3. E2Eテストだけでは担保しきれない領域が存在すること
nimaruには各種帳票のPDFを出力する機能がありますが、PDFの中身などは自動テストの対象にしづらく、引き続き人の目による確認が必要です。こうした領域については、自動化にこだわりすぎず、自動化と人力を組み合わせたハイブリッドな体制を前提とすることが、現実的かつ健全な選択肢だと感じています。

今回の取り組みを通しての学びとみなさんへ伝えたいこと

今回の経験を踏まえ、これから同じような取り組みを行う方に伝えたいポイントは、主に次の3点です。

一つ目は、すべてを自動化しようとしないことです。
E2Eテストで担保すべきなのは、プロダクトにとって「絶対に落とせない操作」に限る、という割り切りが重要だと感じています。

二つ目は、「絶対に落とせない操作」から着手することです。
最初から広く網羅しようとすると、テストケースの作成・保守が重荷になりがちです。まずは影響範囲が大きく、失敗した際のインパクトが大きいユースケースに絞ることで、小さくても確実な価値を出すことができます。

三つ目は、ツール導入そのものをゴールにしないことです。
MagicPodは非常に便利なツールですが、導入すること自体が目的になってしまうと、運用が形骸化しやすくなります。小さく始め、価値を確認しながら徐々に広げていく、そのプロセスを、役職にとらわれず誰かがしっかり主導することが、品質向上をプロダクト改善につなげるうえで重要だと考えています。

まだ取り組みは途中ですが、同じような課題を抱えるチームの参考になれば幸いです。

最後に

kikitoriでは事業拡大に伴い、一緒に働く仲間を募集しています!
ご興味ありましたらぜひお気軽にエントリー・面談をお申し込みください。
お待ちしております!

careers.kikitori.jp

現場とともに進めるDX nimaruアワード2025先進DX事例研究会レポート

こんにちは。株式会社kikitoriでプロダクトマネージャーをしている松本です。

今回は11月に開催された「nimaruアワード2025先進DX事例研究会」について紹介します!

※株式会社kikitoriは「nimaru」という、JA等の集出荷団体や運送会社、市場の方が業務で使うSaaSの開発をおこなっています

nimaruアワード2025先進DX事例研究会は普段からnimaruを積極的に使ってくださっている事業者様を表彰し、その活用事例を共有するイベントです。

イベントは事業者様を表彰するnimaruアワード2025と事業者様とkikitori社員が座談会形式で事例を紹介する先進DX事例研究会の2部で構成されています。

全国のnimaruユーザー様に集まっていただきました

nimaruアワード2025

全国のnimaruを使っていただいている事業者様の中から「導入定着部門」「導入推進部門」「波及創出部門」「組織変革部門」「連携協創部門」「nimaruDX大賞」の合計6部門で表彰させていただきました。

表彰の様子

個人的には使っていただいている事業者様すべてにありがとうございます、なのですが導入当初に既存機能だけでは現場オペレーションがうまくまわらなかった事業者様が表彰されているのを見ると感慨深いものがありました。

もう実際に使っていただいている中、タイムプレッシャーを感じながらも開発部一丸となって頑張ってよかったなと。

今年もたくさんの機能拡充をしたので、その機能をフル活用していただいた事業者様が来年の賞につながれば嬉しいですね。

先進DX事例研究会

先進DX事例研究会では下記の3つのトークセッションと代表上村による今後のnimaruの未来について話すセッションが行われました。

  • セッション①:「壁」を越えて成果へ導く ~nimaru導入推進のリアルと成功要因~
  • セッション②:現場と共に歩むDXの第一歩 ~JA高知県・JA佐波伊勢崎と考える生産者とのコミュニケーションと生産管理の可能性~
  • セッション③:つながる販売、広がる協働 ~nimaruJAが導く市場・物流との新時代の連携モデル~
  • 基調講演:「nimaruが見据える将来構想」

トークセッションの様子

実際に導入していくにあたってのハードルやそれをどう乗り越えたか、新機能を一緒に作っていく上で掘り出していった課題、今後の事業者間の連携などそれぞれ熱く語っていただきました。

導入前の稟議といったフェーズは普段あまり関わることがなく、DXを組織として決断していくのはプロダクトをつくるのとは別の大変さがあるのだなと実際にお話を聞いて再認識です。

nimaruを信じて導入を推進していただいた担当者様には感謝しかありません。

代表上村による講演

基調講演:「nimaruが見据える将来構想」では代表の上村からnimaruの構想、今後の開発ロードマップが共有されました。

参加者皆さんが壇上に映るスライドの写真を撮られていて、将来構想への関心が高いのをひしひしと感じました。

そこまで伝えてしまうのかと内心ヒヤヒヤし引き返せないぞと気を引き締めたのは内緒です。

まとめ

お忙しい中集まっていただいた事業者様への感謝はもちろん、そんな事業者様をこのようなイベントに招待できる関係値を築いてきたBizメンバーに感謝を感じた1日でした。

また、私は普段の業務だと課題感のある現場や新機能のための現場ヒアリングが多くなりなかなか活用が進んでいる現場に行くことができず、今回のイベントで実際にプロダクトを使ってもらえていると実感をもつことができました。

来年もnimaruを導入いただいた方々の期待に応えられるよう機能開発を進めていきたいと思います。

kikitoriではBizメンバーが日々顧客との関係構築を進め、開発のための現場訪問やヒアリングがしやすい環境が整っています。 ユーザーと向き合いながらプロダクト開発を進めていきたいという方はぜひ一度お話ししましょう!

herp.careers